Datensouveränität Fertigung: Datenhoheit praktisch umsetzen
Der Beitrag zeigt, wie echte Datenhoheit entsteht: durch lokale Infrastruktur, klare Zugriffsregeln und vollständige Nachvollziehbarkeit aller KI- und Datenflüsse.
Datenhoheit ist keine Einstellung in einem Cloud-Dashboard. Sie ist eine Architekturentscheidung. Wer Maschinendaten, Qualitätsprotokolle und Prozessparameter an externe Dienste sendet – auch wenn es nur zur Analyse ist – gibt einen Teil der Kontrolle ab. Das betrifft nicht nur Datenschutz, sondern auch operative Sicherheit: Was passiert mit Ihren Produktionsdaten, wenn der Anbieter die Konditionen ändert, verkauft wird oder einfach offline ist?
Was echte Datenhoheit in der Praxis erfordert
- Physische Kontrolle: Die Daten liegen auf Systemen im eigenen Haus – nicht in einem Rechenzentrum, das Sie noch nie gesehen haben.
- Strukturierte Datenhaltung: Ein zentraler Datalake mit klaren Datenpfaden, Zugriffsregeln und Qualitätskriterien – als Basis für jeden KI-Use-Case.
- Nachvollziehbarkeit: Jeder Datenzugriff, jede Modellabfrage und jedes Ergebnis ist dokumentiert und auditierbar – ohne Anbieter-Ticket.
- Unabhängigkeit vom Anbieter-Ökosystem: Keine proprietären Formate, kein Lock-in, kein Datenverlust bei Anbieterwechsel.
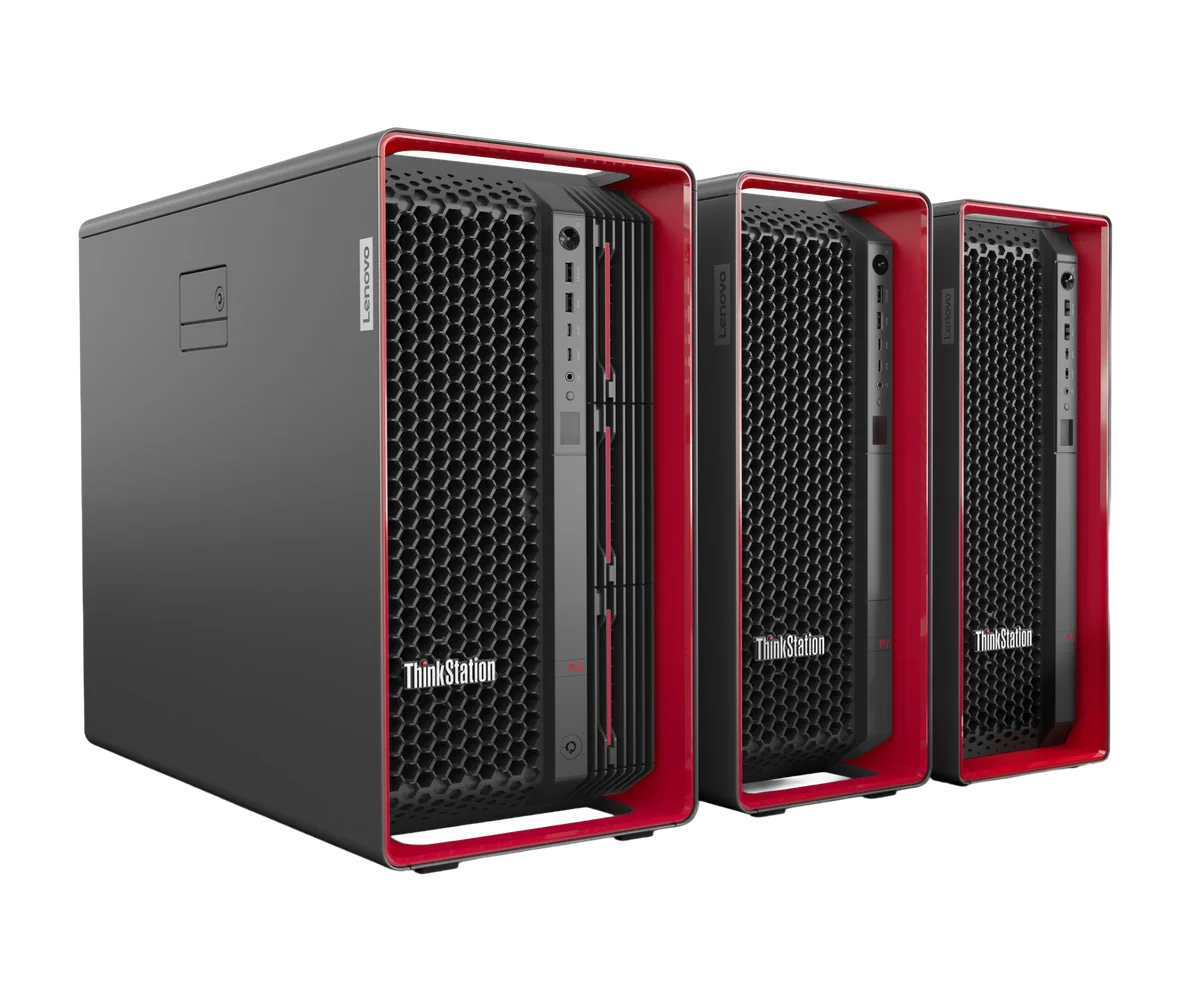
OPAIRS: Datalake und KI-Inferenz unter einem Dach
Das OPAIRS-System integriert einen industriellen Datalake direkt mit der SLM-Inferenzschicht – alles lokal, alles unter Ihrer Kontrolle. Produktionsdaten fließen nicht durch fremde APIs. Modelle werden lokal ausgeführt. Ergebnisse landen direkt im angebundenen BI-Dashboard. Own your Data again – das ist keine Kernbotschaft, sondern eine technische Tatsache.
Governance ist der organisatorische Rahmen, der diese technische Grundlage nutzbar macht: klare Rollen, definierte Zugriffsgrenzen, messbare Qualitätskriterien. Mit OPAIRS bauen Sie beides gleichzeitig auf – Infrastruktur und Governance-Fundament – statt eines nach dem anderen.
Weitere Insights
OPAIRS Forecasting: Selbst gehostete Zeitreihenprognose für die Fertigung
Wie viel Material verbrauchen wir im nächsten Quartal, wann steigt der Energiebedarf, welche Artikel laufen aus? Solche Fragen beantworten Zeitreihenprognosen – bisher meist über Cloud-Dienste, in die Produktionsdaten abfließen. OPAIRS hat einen eigenen Prognose-Dienst gebaut, der vollständig lokal läuft, nur dann ein Modell empfiehlt, wenn es eine einfache Baseline nachweislich schlägt, und sich mit dem SQL-Agenten zu einer durchgehenden Kette verbindet: Daten abfragen, prognostizieren, bewerten.
Beitrag lesen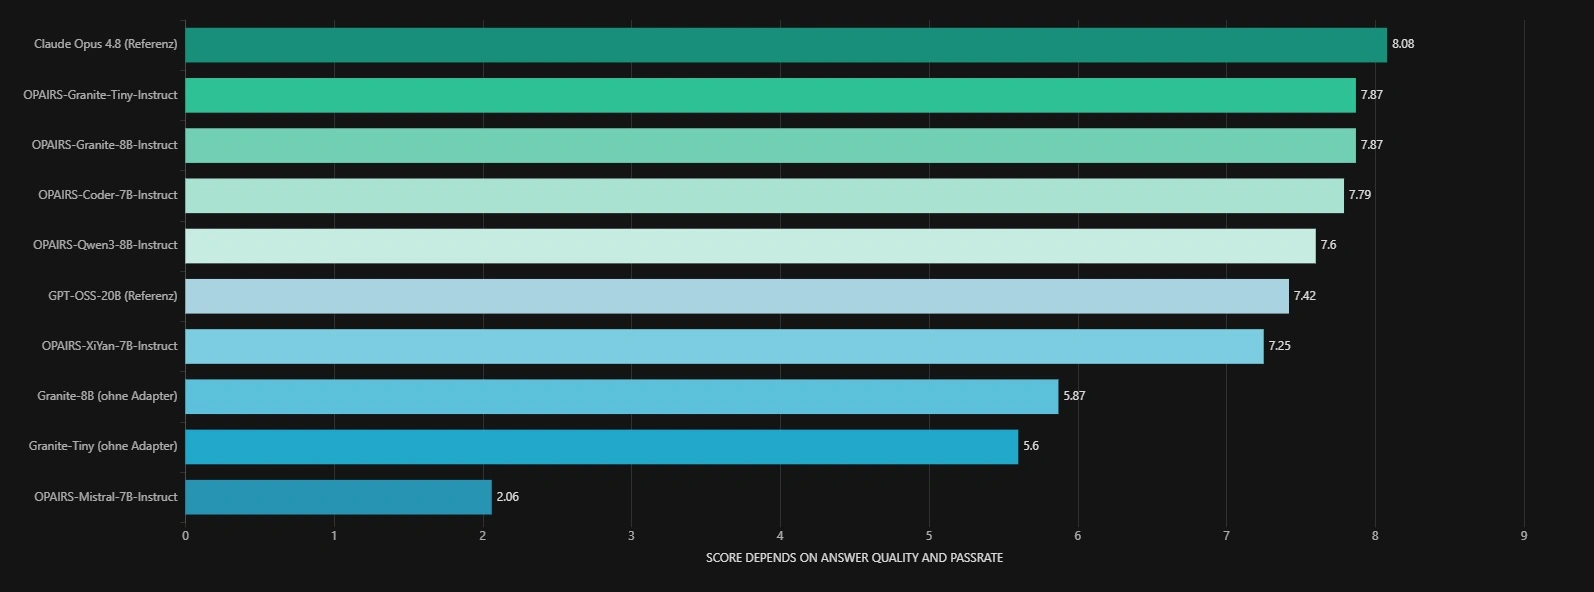
OPAIRS SQL-Agent: Sechs LoRA-Adapter für industrielle Datenbanken im Vergleich
Sechs LoRA-Adapter, ein 26-Fragen-Katalog aus PostgreSQL-, T-SQL- und Apache-Iceberg-Datenbanken, zwei externe Referenzmodelle: OPAIRS hat den SQL-Agenten systematisch evaluiert. Zwei Granite-Adapter liegen an der Spitze. Für den produktiven Einsatz entscheidet am Ende aber nicht nur die Antwortqualität, sondern auch Geschwindigkeit, Speicherbedarf, Parallelität und der verfügbare Kontext aus ERP-, MES-, PLM- und weiteren industriellen Systemen.
Beitrag lesen